
El problema: leer miles de imágenes sin perder lo que importa
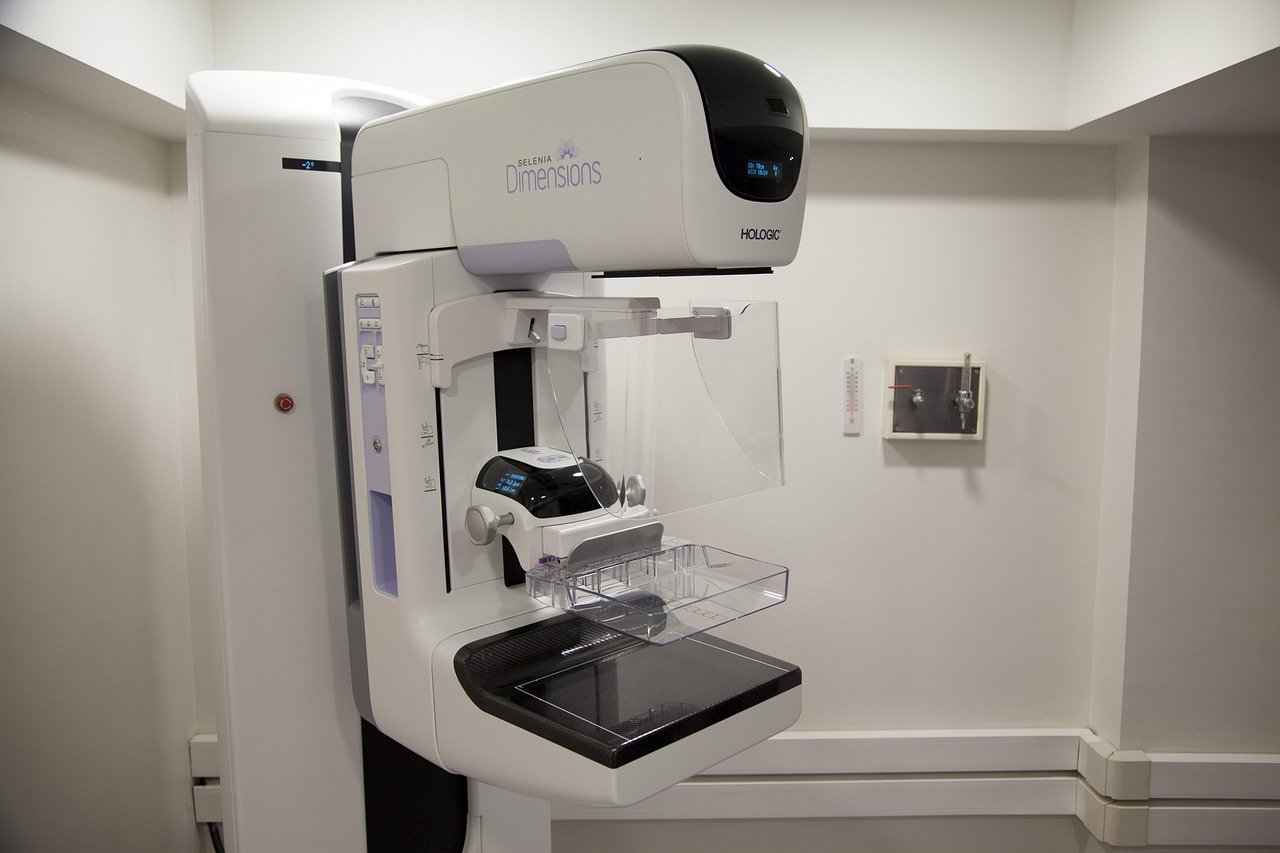
Quien trabaja en un servicio de radiología o en un programa de cribado conoce la ecuación: muchas imágenes, pocos especialistas y, en el caso de las mamografías, una doble lectura que protege al paciente pero consume horas. Cualquier herramienta que prometa aliviar esa carga se encuentra con una pregunta incómoda: ¿detecta lo mismo, más o menos, y a qué precio?
Sobre el papel, la inteligencia artificial (IA) puede hacer tres cosas: priorizar casos, decidir cuáles necesitan una o dos lecturas humanas y resaltar zonas sospechosas para que el profesional las mire con más atención. Lo que importa a quien decide una compra no es si es posible, sino qué se ha medido de verdad, con qué datos y qué queda sin resolver. Vayamos al caso con dos áreas donde hay estudios publicados: el cribado de cáncer de mama y la retinopatía diabética. Después, los costes, los sesgos y la regulación.
Mamografías: lo que midió el ensayo MASAI en Suecia
El ensayo MASAI es un ensayo aleatorizado y controlado dentro del programa nacional sueco de cribado, en cuatro centros del suroeste del país (Malmö, Lund, Landskrona y Trelleborg). Entre el 12 de abril de 2021 y el 7 de diciembre de 2022 se asignó al azar a 105 934 mujeres a cribado con apoyo de IA o a la doble lectura estándar (The Lancet Digital Health, 3 de febrero de 2025).
El sistema usado fue Transpara v1.7.0, de ScreenPoint Medical; lo citamos solo como dato del estudio. Servía para derivar cada mamografía a lectura simple o doble y como apoyo a la detección, al resaltar hallazgos sospechosos.
Los resultados de ese análisis fueron:
- Detección: 6,4 cánceres por 1000 con IA frente a 5,0 por 1000 en el grupo control, un cociente de 1,29 (intervalo de confianza del 95 %: 1,09-1,51, es decir, el rango en el que probablemente se sitúa el valor real). En números absolutos, 338 cánceres frente a 262.
- Tipo de cáncer: 270 invasivos frente a 217, y 68 in situ frente a 45.
- Reconvocatorias: 1110 con IA frente a 1027 en el grupo estándar. Ni las reconvocatorias ni los falsos positivos aumentaron de forma significativa (cocientes de 1,08 y 1,01). El valor predictivo positivo de la reconvocatoria fue mayor con IA (cociente de 1,19).
Sobre la carga de trabajo, The ASCO Post recoge dos análisis previos distintos del ensayo: los resultados intermedios, publicados en The Lancet Oncology, mostraron un 44 % menos de carga de lectura para los radiólogos; y el análisis de The Lancet Digital Health, citado arriba, un 29 % más de cánceres detectados sin aumentar los falsos positivos.
El matiz que decide si esto importa
Los datos de arriba son un análisis de resultados secundarios, definido en el protocolo. El objetivo principal del ensayo es la tasa de cánceres de intervalo, es decir, los diagnosticados entre dos rondas de cribado. Los resultados finales se publicaron en The Lancet (DOI 10.1016/S0140-6736(25)02464-X) y The ASCO Post los resume así: ensayo de no inferioridad, de base poblacional y con esa variable como principal.
Según esa fuente, los cánceres de intervalo fueron 1,55 por 1000 con IA frente a 1,76 por 1000 con la lectura estándar (cociente de 0,88; intervalo de confianza del 95 %: 0,65-1,18; p = 0,41). Es decir, la cifra es más baja con IA, pero la diferencia no es estadísticamente significativa: con estos datos no puede descartarse que sea fruto del azar. La sensibilidad (la proporción de cánceres que el cribado encuentra) fue del 80,5 % con IA frente al 73,8 % en el grupo control, y la especificidad (la proporción de mujeres sanas a las que se da correctamente el alta) fue del 98,5 % en ambos grupos.
La razón de insistir es sencilla: detectar más cánceres no equivale a salvar más vidas. La variable de los cánceres de intervalo es la que ayuda a aclarar cuánto del aumento de detección se traduce en un beneficio real, y aquí el resultado es favorable en la cifra pero no concluyente en lo estadístico.
Y un límite de contexto: es un programa poblacional sueco, en cuatro centros y con un sistema concreto. No conviene extrapolarlo sin más a otros países, otros equipos u otros programas.
Retinopatía diabética: del 90 % de precisión a la clínica tailandesa
Google atribuía a su sistema de detección de retinopatía diabética una «precisión de nivel especialista» superior al 90 % para identificar casos derivables, según recogió Newsweek el 28 de abril de 2020. Es una cifra de la empresa, y así hay que leerla.
Qué pasó cuando el sistema llegó a la consulta lo cuenta un estudio de campo en once clínicas de las provincias tailandesas de Pathum Thani y Chiang Mai, entre noviembre de 2018 y agosto de 2019, presentado en CHI 2020. Según Newsweek (traducción nuestra): «De las 1838 imágenes que pasaron por el sistema en los primeros seis meses de uso, 393 (21 %) no cumplieron sus altos estándares para ser clasificadas».
Había más fricciones prácticas:
- Los procesos de cribado variaban mucho entre clínicas.
- No todas tenían buena conexión a internet.
- En algunos casos el sistema parecía ralentizar procesos que ya eran lentos.
- Las enfermeras debían sopesar su confianza en el sistema y si la derivación recomendada sería una carga innecesaria para el paciente, por ejemplo por el viaje a un hospital lejano.
Conviene leerlo con equilibrio. El trabajo se basó en observación y entrevistas a enfermeras, y las fuentes consultadas no detallan medidas de precisión de ese estudio. La investigadora Emma Beede dijo a Newsweek que el estudio buscaba descubrir los factores que afectan al rendimiento de la IA en entornos reales, y que el fallo habría sido desplegarla del todo sin estudiar su uso. Los autores defienden evaluar el uso en clínica junto con evaluaciones prospectivas de precisión antes de un despliegue amplio, y señalan una tensión entre los umbrales de calidad de datos del modelo y los datos que se obtienen en un entorno imperfecto y con pocos recursos.
Mi opinión: la cifra de precisión que anunciaba la empresa responde a una pregunta distinta de la que se hace quien compra. Aquella pregunta es cuánto acierta el sistema con las imágenes que sí clasifica; el centro necesita saber qué ocurre con las imágenes que tiene, con su conexión y con su personal.
Lo que cuesta y lo que hace falta
Las fuentes consultadas no aportan cifras de coste, así que no las hay aquí. Sí muestran qué partidas hay que mirar, y ninguna es el algoritmo en sí:
- Imagen de calidad y conexión. El 21 % de imágenes sin clasificar en Tailandia y la conexión irregular de algunas clínicas indican que el equipo de captura y la infraestructura forman parte del proyecto.
- Integración en el flujo de trabajo. Si los procesos de cada centro son distintos, el sistema se adapta a ellos o los ralentiza.
- Personas con formación y autoridad. El Reglamento de IA exige, como se verá más abajo, que la supervisión humana recaiga en personas con competencia, formación y autoridad; eso es tiempo y capacitación, no una licencia.
- Documentación y trazabilidad. Registro de actividad y documentación técnica que alguien tiene que custodiar y entender.
¿Y quién paga esto el segundo año, cuando ya no hay presupuesto de innovación? La cuenta tiene que salir con todas esas partidas, no solo con la del producto.
Sesgos: quién queda peor atendido
Un estudio de Nature Medicine (diciembre de 2021) analizó clasificadores de radiografías de tórax con tres conjuntos de datos públicos grandes y uno combinado. Encontró que subdiagnosticaban de forma sistemática a poblaciones menos atendidas: mujeres, pacientes negros, hispanos, jóvenes y de menor nivel socioeconómico (beneficiarios de Medicaid, el seguro público estadounidense para personas con pocos recursos). La tasa fue mayor en subgrupos interseccionales, como las mujeres hispanas. Los autores advierten de que desplegar estos sistemas puede agravar sesgos existentes y generar un acceso desigual al tratamiento.
El propio estudio tiene un límite: es retrospectivo y con datos públicos, no un ensayo en clínica.
Una revisión sistemática publicada en Cureus (agosto de 2026) apunta en la misma dirección. Reúne 27 estudios de 2015 a 2026, sobre todo observacionales y retrospectivos, en radiografía de tórax, ecografía mamaria e imagen oftalmológica. La mayoría concluyó que los sistemas entrenados con datos desequilibrados tendían a más subdiagnóstico, menor sensibilidad o menor valor predictivo en pacientes no blancos. Lo tomo como apoyo y no como prueba única: Cureus es una revista de acceso abierto con menor peso que las de primer nivel, y los datos son de Estados Unidos.
Para un centro, la consecuencia práctica es pedir resultados desglosados por subgrupos y comprobar si los datos de entrenamiento se parecen a su población. Un buen resultado global puede esconder un mal resultado en un grupo concreto.
Lo que puede salir mal
- Generalización. Lo medido en Suecia o con imágenes ideales no garantiza lo mismo en otro hospital, con otros equipos, otra población y otra calidad de imagen. Es un problema distinto del sobreajuste, que describe a un modelo que memoriza sus datos de entrenamiento, aunque ambos son motivos para exigir pruebas con datos propios.
- Sesgos que no se ven. Si solo se mira la cifra global, un peor rendimiento en un subgrupo pasa desapercibido.
- Supervisión humana. Una IA que prioriza o descarta cambia quién mira qué. La decisión final y la responsabilidad deben tener dueño, y los profesionales necesitan saber qué hacer cuando discrepan de la máquina.
- Cifras de proveedor. Un resultado publicado en una revista revisada, un anuncio comercial y una opinión no pesan igual. Las cifras de rendimiento que da quien vende la solución merecen la misma cautela que un anuncio.
Regulación: qué exige el Reglamento de IA y qué queda por comprobar
Según la Comisión Europea, los sistemas de IA de alto riesgo deben cumplir, entre otras, estas obligaciones: evaluación y mitigación de riesgos, conjuntos de datos de alta calidad para minimizar resultados discriminatorios, registro de actividad para la trazabilidad, documentación detallada, información clara al implementador, medidas de supervisión humana y un alto nivel de robustez, ciberseguridad y precisión.
El Reglamento (UE) 2024/1689 (versión consolidada en EUR-Lex a 27 de julio de 2026) concreta en su artículo 14 que estos sistemas deben diseñarse para que personas físicas puedan vigilarlos de manera efectiva. La documentación técnica debe permitir a los responsables del despliegue interpretar los resultados y usarlos adecuadamente. Y su artículo 26.2 obliga al responsable del despliegue a asignar la supervisión humana a personas con la competencia, la formación y la autoridad necesarias.
El calendario cambió con el llamado «AI Omnibus». Según la página de la Comisión Europea sobre la Ley de IA, se adoptó como propuesta el 19 de noviembre de 2025, tuvo acuerdo político el 7 de mayo de 2026 y entró en vigor el 27 de julio de 2026, la misma fecha de la versión consolidada del Reglamento citada arriba. Con él, los sistemas de alto riesgo integrados en productos regulados (anexo I) tienen un período transitorio ampliado hasta el 2 de agosto de 2028, y los casos de uso del anexo III se prorrogan hasta el 2 de diciembre de 2027 (ambas fechas, según la Comisión).
Aquí hay un límite explícito: las fuentes consultadas no detallan cómo se aplica ese calendario al software de diagnóstico por imagen como producto sanitario. Habrá que comprobarlo en el texto del Reglamento y en la normativa de productos sanitarios, y no afirmamos ninguna fecha concreta para este caso. Esto no es asesoramiento legal.
Preguntas antes de empezar
- ¿Con qué población y qué equipos se midió el sistema, y se parece a la nuestra? ¿Hay resultados por subgrupos?
- ¿Qué variable se evaluó: detección, cánceres de intervalo, carga de lectura o impacto en el paciente? ¿Quién publicó la cifra y existe un estudio independiente?
- ¿Cómo encaja con nuestro flujo de trabajo? ¿Qué pasa con las imágenes que el sistema no puede clasificar y quién revisa los avisos y decide cuando máquina y profesional discrepan?
- ¿Quién paga el mantenimiento y la supervisión el segundo año, y qué exige la normativa aplicable a un producto sanitario con IA?
Si necesitas entender cómo aprende uno de estos modelos antes de evaluarlo, empieza por nuestra guía de cómo funcionan las redes neuronales o por la introducción al aprendizaje automático. Este texto describe lo publicado y no recomienda productos ni sustituye al criterio clínico.
Fuentes
- Screening performance and characteristics of breast cancer detected in the Mammography Screening with Artificial Intelligence trial (MASAI) – The Lancet Digital Health, 3 de febrero de 2025 (PubMed)
- Randomized Trial Shows AI-Supported Mammography Improves Sensitivity and Lowers Interval Cancer Rate – The ASCO Post, febrero de 2026
- A Human-Centered Evaluation of a Deep Learning System Deployed in Clinics for the Detection of Diabetic Retinopathy – Google Research / CHI 2020
- Google’s AI Health Screening Tool Claimed 90 Percent Accuracy, but Failed to Deliver in Real World Tests – Newsweek, 28 de abril de 2020
- Underdiagnosis bias of artificial intelligence algorithms applied to chest radiographs in under-served patient populations – Nature Medicine, diciembre de 2021 (PubMed)
- Racial and Ethnic Disparities in the Diagnostic Performance of AI Systems for Medical Imaging in the United States: A Systematic Review – Cureus, agosto de 2026
- Ley de IA – Comisión Europea (Configurar el futuro digital de Europa)
- Reglamento (UE) 2024/1689 (Ley de IA), versión consolidada a 27 de julio de 2026 – EUR-Lex
Imagen: AlarconAudiovisual en Pixabay